 Jenna
Pré-évaluation IA pour un centre de formation Active IQ
Power & Revive dirige la Fitness Trainer Academy, un centre britannique qui délivre les formations Active IQ niveau 2 (Level 2) Gym Instructor et Level 3 Personal Trainer. Chaque chapitre remis par un apprenant est corrigé à la main sur le portail du centre. Nous avons installé Jenna comme évaluateur de première passe sur ce portail : une notation fondée sur le guide d'évaluation de l'organisme certificateur, des retours rédigés comme un formateur les rédigerait, et l'évaluateur humain qui garde le dernier mot.
Septembre à octobre 2026 · Apprenants anonymisés en Student B et Student S · Captures d'écran issues de vraies exécutions, noms retirés
Le problème
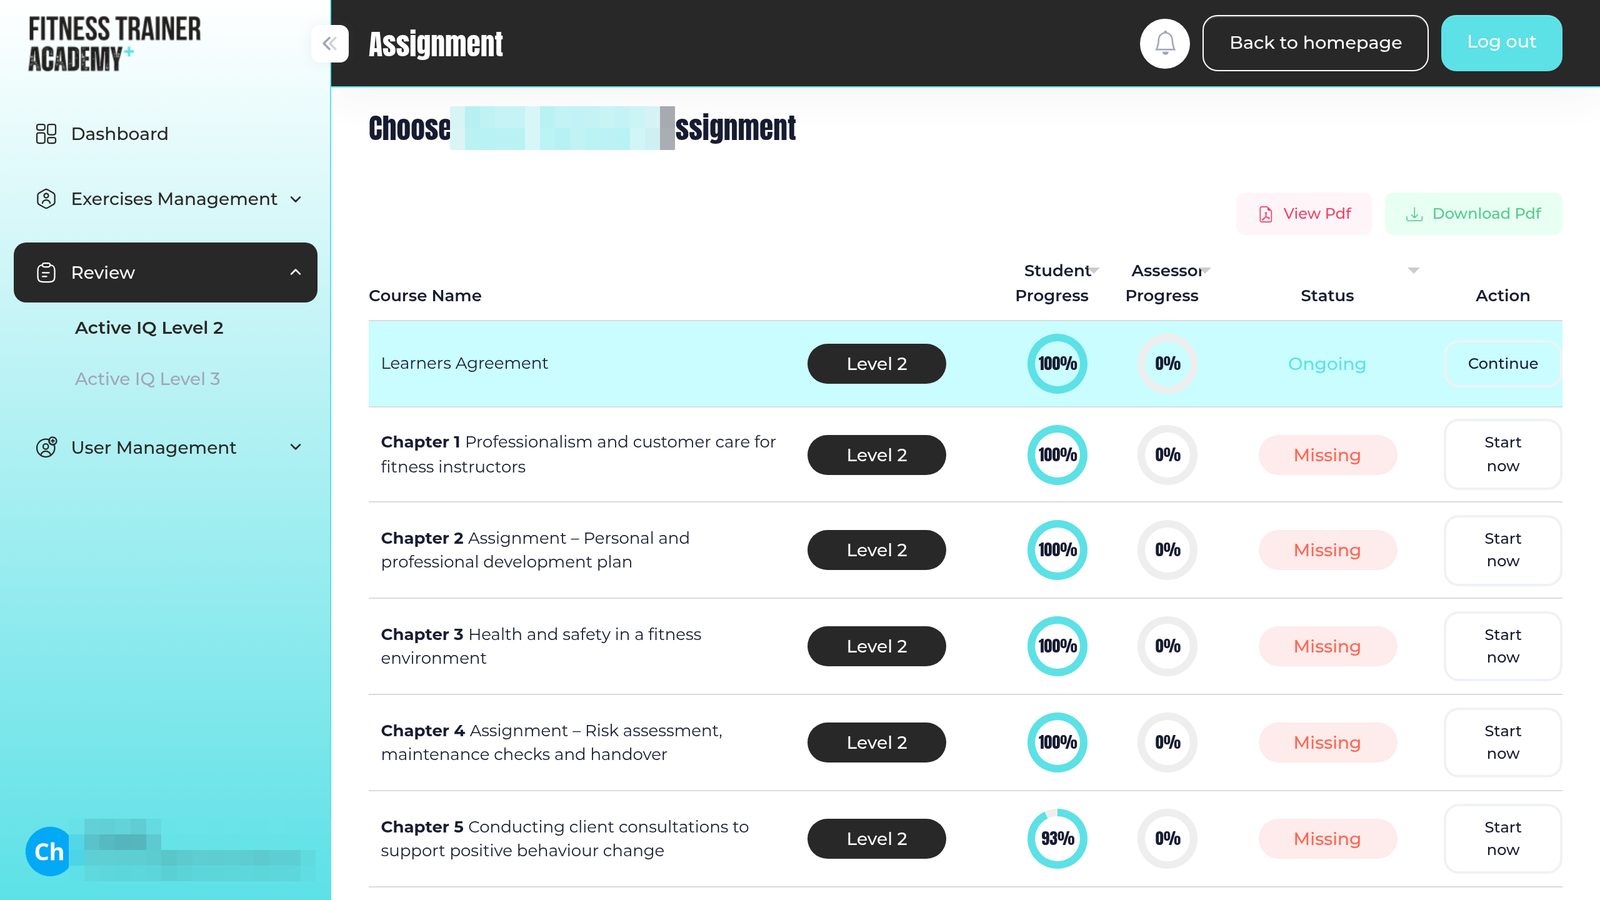
Les apprenants remettent leurs devoirs écrits chapitre par chapitre, neuf chapitres au Level 2 et sept au Level 3. Un évaluateur ouvre chaque apprenant, lit chaque réponse au regard du barème officiel Active IQ, saisit une note par question, rédige un retour là où des points sont perdus, et enregistre « Pass » (validé) ou « Refer » (renvoyé). Chaque chapitre demande 20 à 40 minutes de temps qualifié, les apprenants remettent au fil de l'eau plutôt que par lots, et le portail n'offre aucune vue des « chapitres en attente de correction ».
Le centre voulait automatiser la première passe sans abaisser le niveau d'exigence : les notes doivent suivre le guide d'évaluation de l'organisme certificateur, les retours ne doivent jamais révéler la réponse attendue, et l'évaluateur doit rester responsable de chaque « Pass ».
Ce que nous avons mis en place
Jenna pilote un vrai navigateur sur le portail du centre, connectée avec un compte évaluateur dédié. Aucune intégration avec la plateforme d'apprentissage, rien à installer : le portail n'a été modifié en aucune façon.
Corrige comme un formateur
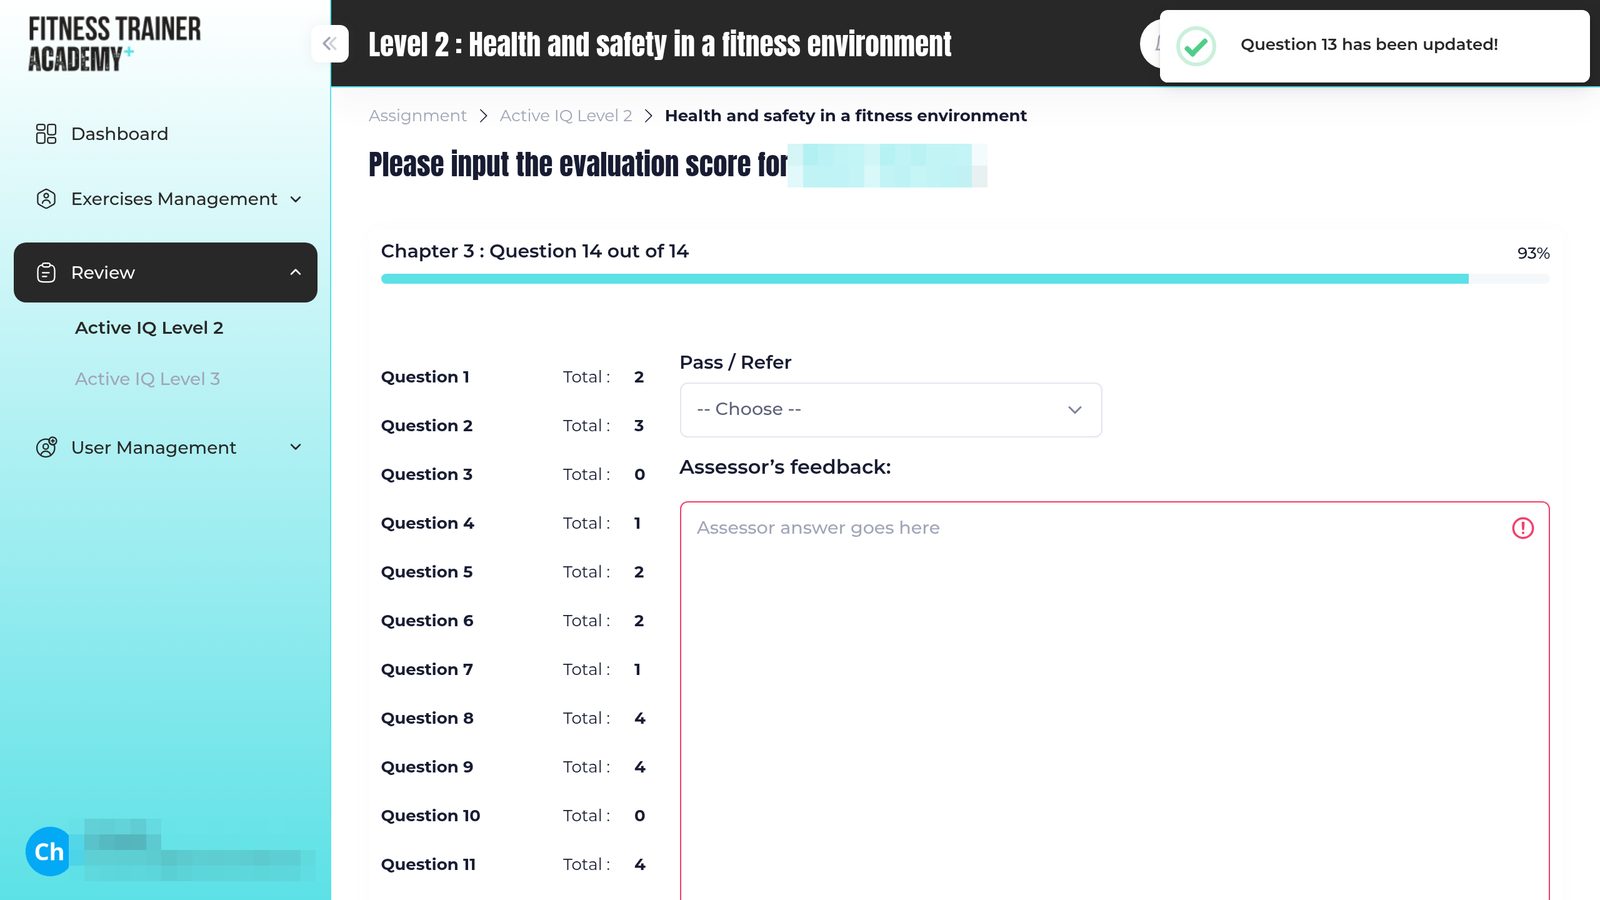
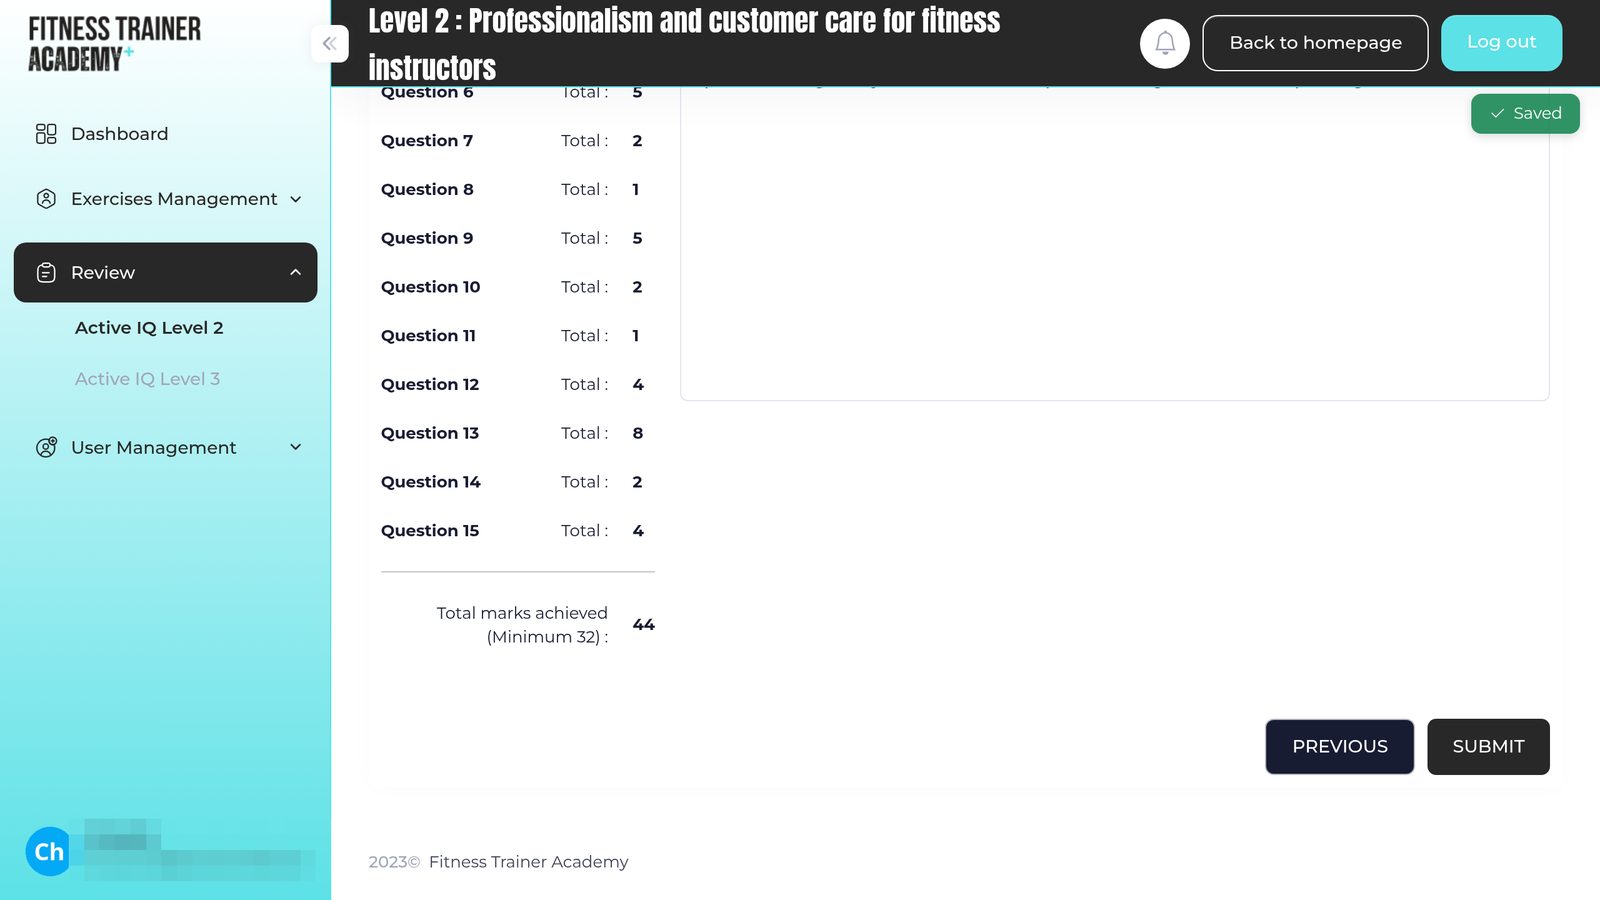
Quand une réponse est insuffisante, Jenna laisse un commentaire qui indique quoi retravailler sans donner la réponse, enregistre la note qu'elle peut justifier, et attend que l'apprenant révise. Elle ne renvoie jamais un apprenant de sa propre initiative. Un « Pass » n'est enregistré que lorsque chaque question atteint son minimum et que le total atteint le seuil de validation.
Fondée sur le guide d'évaluation
Chaque critère, chaque note et chaque minimum provient du guide d'évaluation Active IQ, mot pour mot, chargé comme connaissance par question que Jenna consulte pendant la correction. Nous n'inventons jamais de critères de notation. Là où le guide laisse l'appréciation à l'évaluateur, le niveau d'exigence est dérivé de ses propres corrections.
Une mission par chapitre
Chaque chapitre est une mission réutilisable qui porte la liste des apprenants à évaluer. Une nouvelle promotion, c'est la même mission avec de nouveaux noms. Les exécutions sont lancées quand les apprenants remettent leur travail, et l'évaluateur relit chaque résultat dans le portail exactement comme avant.
Une exécution, étape par étape
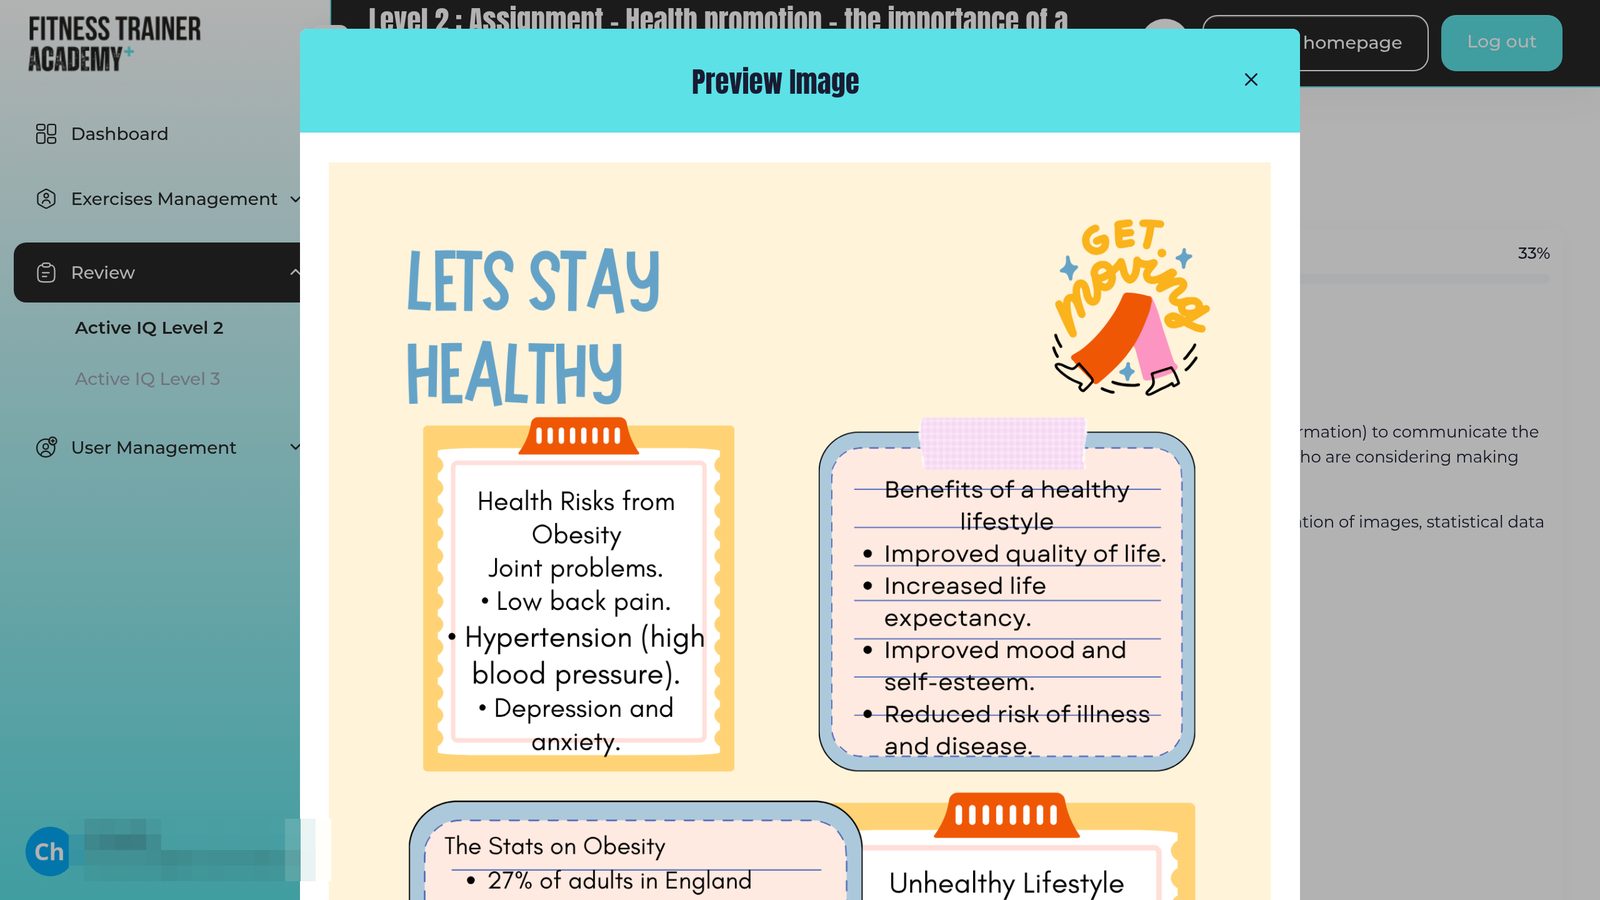
Chaque exécution est enregistrée. Chaque étape conserve une capture d'écran, ce que Jenna cherchait à faire et pourquoi, de sorte que l'évaluateur peut remonter de n'importe quelle note jusqu'aux mots mêmes de l'apprenant. Ci-dessous, des images tirées des exécutions de septembre 2026 pour Student S.
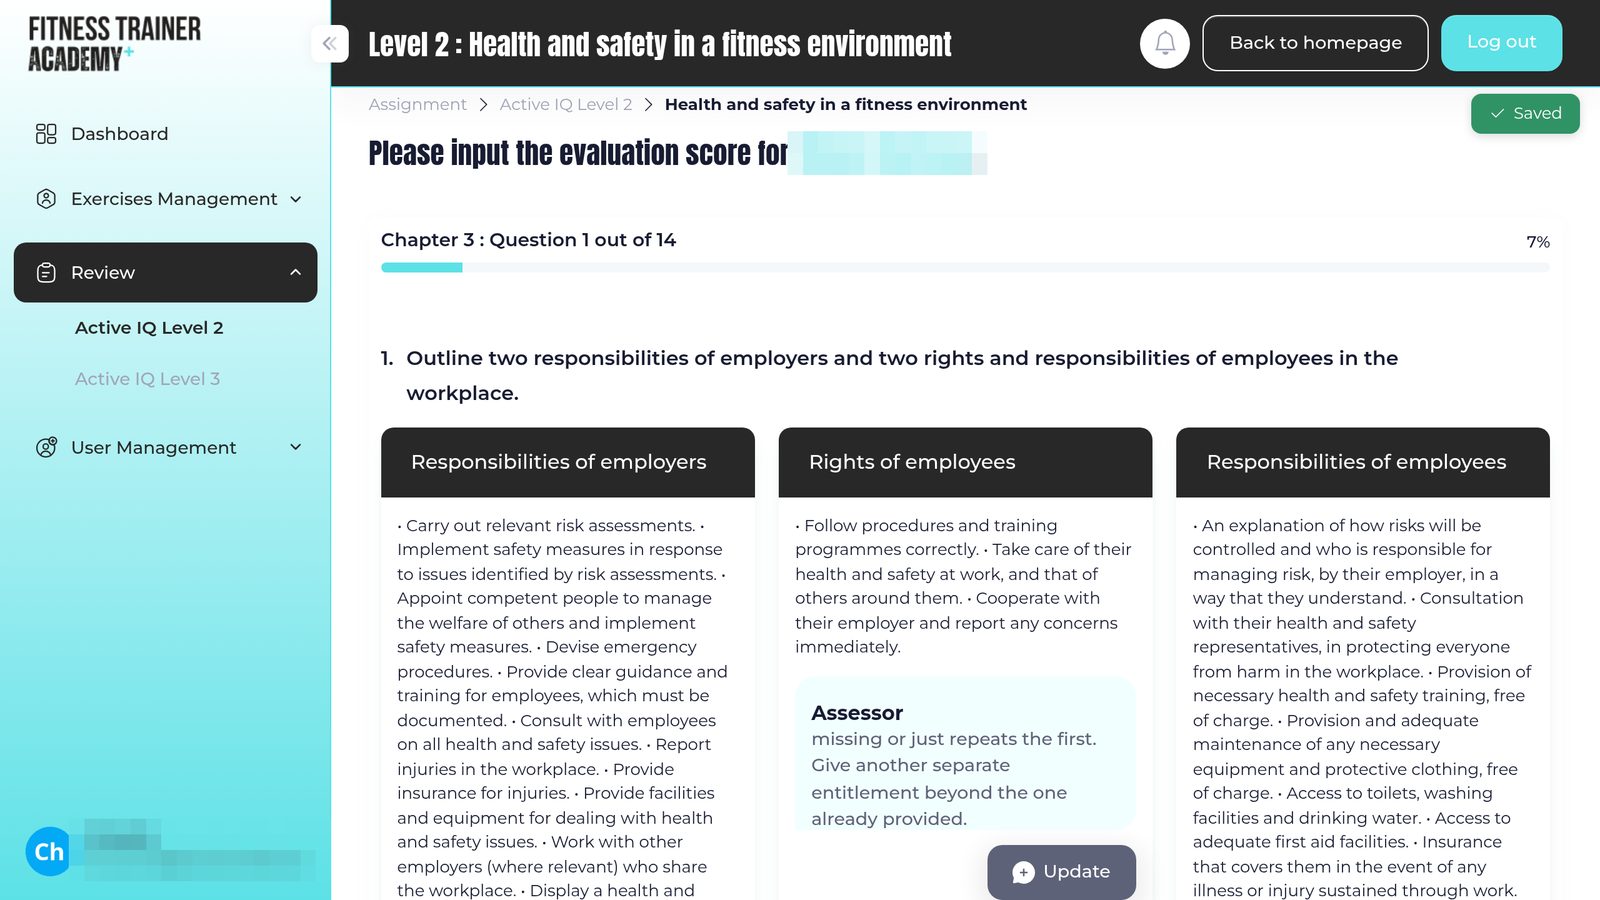
Ce que Jenna a consigné pour cette étape« Rédaction d'un retour pour la partie sur les droits des salariés, afin de guider l'apprenant vers la correction de ses réponses interverties. »
« Le premier droit du salarié indiqué est absent ou ne fait que répéter le premier. Indiquez un autre droit, distinct de celui déjà donné. »
Comment nous l'avons vérifiée avant de lui faire confiance
Un taux d'accord, à lui seul, ne dit pas grand-chose. Nous voulions savoir où l'automatisation se tromperait, dans quel sens, et si ce sens est sans risque.
1. Vérité terrain : un apprenant déjà corrigé par l'évaluateur
Avant toute exécution en conditions réelles, le niveau d'exigence a été appliqué en aveugle à un apprenant que l'évaluateur du centre avait entièrement corrigé. Les notes ont coïncidé sur 38 des 40 critères textuels. Sur chacune des quatre questions où l'évaluateur avait retiré des points, la même note a été obtenue pour la même raison.
| Question (apprenant déjà corrigé) | Évaluateur du centre | Correcteur de référence en aveugle | Raison commune |
|---|---|---|---|
| Ch1 Q12 | 4 / 6 | 4 / 6 | Aucun résultat énoncé, donc le second point de « détail » retenu |
| Ch2 SWOT | 6 / 8 | 6 / 8 | Détail supplémentaire sur l'opportunité et la menace non atteint |
| Ch3 Q10 | 1 / 2 | 1 / 2 | « Coupures » n'est pas un effet d'une substance dangereuse |
| Ch5 Q4 | 7 / 10 | 7 / 10 | Lecture stricte des exemples d'aliments |
2. Exécutions réelles, recorrigées en aveugle
Les cinq chapitres écrits de Student B ont été pré-corrigés en conditions réelles, puis recorrigés indépendamment, à partir des captures d'écran des exécutions, par un correcteur de référence qui n'avait pas vu les notes de Jenna. L'accord a été exact sur un chapitre et à un à trois points près sur les autres. Chaque désaccord allait dans le même sens : Jenna était plus généreuse, toujours sur les critères de « réponse plus détaillée » que le guide laisse à l'appréciation. Sur un chapitre, cette générosité a fait remonter une réponse sous le minimum jusqu'à son minimum, un « Pass » là où la lecture stricte dit mise en attente.
| Student B, Level 2 | Jenna (première exécution réelle) | Référence en aveugle | Remarque |
|---|---|---|---|
| Ch1 Professionnalisme | 49 / 49 | 46 / 49 | Trois points de « détail » ; deux corrigés ensuite |
| Ch2 Plan de développement | 15 / 15 | 14 / 15 | La référence a mal lu un tableau à liste déroulante ; Jenna avait raison |
| Ch3 Santé et sécurité | 37 / 37 | 36 / 37 | Une répétition courtoisie contre sécurité |
| Ch4 Évaluation des risques | 20 / 21 | 20 / 21 | Exact, y compris la même déduction pour la même raison |
| Ch5 Entretiens clients | 36 / 38 | 33 – 34 / 38 | Concept erroné sur la Q2 ; le verdict bascule en mise en attente |
Pourquoi c'est important. Si l'automatisation est plus indulgente que l'évaluateur, chaque « Pass » doit être revérifié et l'économie disparaît. Une première passe plus stricte coûte une révision à l'apprenant. Une première passe indulgente coûte au centre un faux « Pass ». Le référentiel a donc été orienté vers la sévérité, et les propres corrections de l'évaluateur ont servi à fixer la barre.
3. Calibrage sur les propres retours de l'évaluateur
Le portail a été lu par de simples requêtes de pages, plafonnées à une requête par seconde, sans clic ni modification : six apprenants sur les deux niveaux, 942 requêtes, zéro erreur. Cela a produit plus de 500 retours, les mots mêmes de l'évaluateur sur ce qui manquait et ce qui est attendu. Nous en avons dérivé une couche de calibrage, tenue séparée du texte de l'organisme certificateur, et relancé les questions que Jenna avait surnotées, notes effacées. Sept des neuf questions ciblées ont rejoint la note de référence ; les deux écarts restants sont de véritables questions d'appréciation. Quatre questions de contrôle sont restées inchangées.
Une leçon de cette phase : recorriger une page qui affiche déjà une note ne teste pas la sévérité, parce que le modèle s'ancre sur le chiffre visible. La sévérité ne se teste que sur des cases de notes vides.
Résultats
Deux apprenants sur les chapitres 1 à 6 du Level 2, à la date d'octobre 2026. Les chapitres 7 à 9 sont des évaluations pratiques qui ne sont pas corrigées en ligne.
| Chapitre | Student B (9 – 11 septembre) | Student S (21 septembre) |
|---|---|---|
| 1 Professionnalisme et relation client | 47 / 49 · Pass | 44 / 49 · Pass |
| 2 Plan de développement personnel et professionnel | 15 / 15 · Pass | 13 / 15 · Pass |
| 3 Santé et sécurité | 36 / 37 · Pass | 24 / 37 · Mis en attente avec commentaires sur 5 questions |
| 4 Évaluation des risques, maintenance, passation | 20 / 21 · Pass | 20 / 21 · Pass |
| 5 Entretiens clients | 34 / 38 · Une question sous le minimum, mis en attente | Non commencé : apprenant à 93 % |
| 6 Affiche de promotion de la santé | 13 / 13 · Pass | Pass |
Chaque « Pass » est soumis sous le compte évaluateur et relu par l'évaluateur du centre, qui reste responsable du résultat. Les chapitres mis en attente attendent la révision de l'apprenant.
Ce que cela coûte
| Correcteur | Temps par chapitre | Coût par chapitre |
|---|---|---|
| Évaluateur du centre | 20 – 40 minutes | ≈ 7 – 13 € |
| Jenna, modèle standard | ≈ 36 minutes de temps navigateur | ≈ 1,4 € |
| Jenna, modèle à effort élevé (utilisé pour la correction) | 30 – 50 minutes de temps navigateur, facturées à 2,5× | ≈ 3,5 € |
Les six chapitres de Student S ont tourné en parallèle et se sont achevés en 37 minutes de temps réel, en consommant environ 296 minutes d'automatisation sur l'abonnement du centre.
Ce que nous avons raté, et corrigé
- La première exécution réelle a sauté des questions et n'a écrit aucun commentaire. La cause se trouvait dans la gestion des connaissances du moteur, pas dans la mission. Nous avons corrigé la cause racine ; depuis, chaque exécution boucle le cycle complet : note, commentaire, verdict et soumission.
- Nous avions commencé à écrire nos propres critères de notation. Là où le guide dit seulement « une description plus détaillée et précise », nous avions entrepris de définir ce que cela signifiait. Le centre l'a relevé. Nous sommes revenus en arrière dans l'heure et avons consigné la règle : le texte du guide, rien d'autre, et le niveau d'exigence appartient à l'évaluateur.
- Les réponses longues bloquaient la lecture. Des réponses sur plusieurs écrans et des zones de commentaire identiques ont provoqué des boucles dans deux exécutions de revalidation. Les deux ont été arrêtées volontairement, rien n'a été altéré sur le portail, et le moteur a gagné une lecture exacte des pages et un adressage exact des champs.
- Les affiches en PDF étaient invisibles pour le navigateur headless. Le moteur est passé en mode headless Chromium complet pour que l'aperçu PDF du portail s'affiche, et le chapitre 6 se corrige désormais de bout en bout.
- Les vérifications planifiées gaspillent de l'argent. Contrôler chaque apprenant tous les deux jours brûle des minutes en connexions qui ne trouvent rien à faire. Les exécutions sont désormais lancées quand les apprenants remettent leur travail.
Où nous en sommes
- En production : chapitres 1 à 6 du Level 2, pré-corrigés à la demande, l'évaluateur confirmant au seuil de validation.
- Décision en suspens pour le centre : le minimum de validation du portail est la somme des minima par question, inférieur au seuil de validation du guide officiel. L'automatisation applique pour l'instant le chiffre officiel, plus strict.
- Prochaine étape : étendre la cohorte de calibrage à 20 à 30 apprenants corrigés par l'évaluateur, faire ratifier les règles dérivées par l'évaluateur, puis le Level 3.
Les régulateurs et les organismes certificateurs sont clairs : l'IA ne doit jamais être le seul correcteur. Ce dispositif est bâti sur ce principe : c'est un copilote de l'évaluateur avec validation humaine, pas une correction automatique.
Vous dirigez un centre de formation avec le même goulot d'étranglement ?
Nous mettons cela en place sur votre portail existant, le mesurons contre votre évaluateur avant que vous ne vous y fiiez, et gardons votre évaluateur aux commandes.